公開: 2025年12月29日
最終更新: 2025年12月29日
アプリとAPIにつなぐPDF・文書自動化
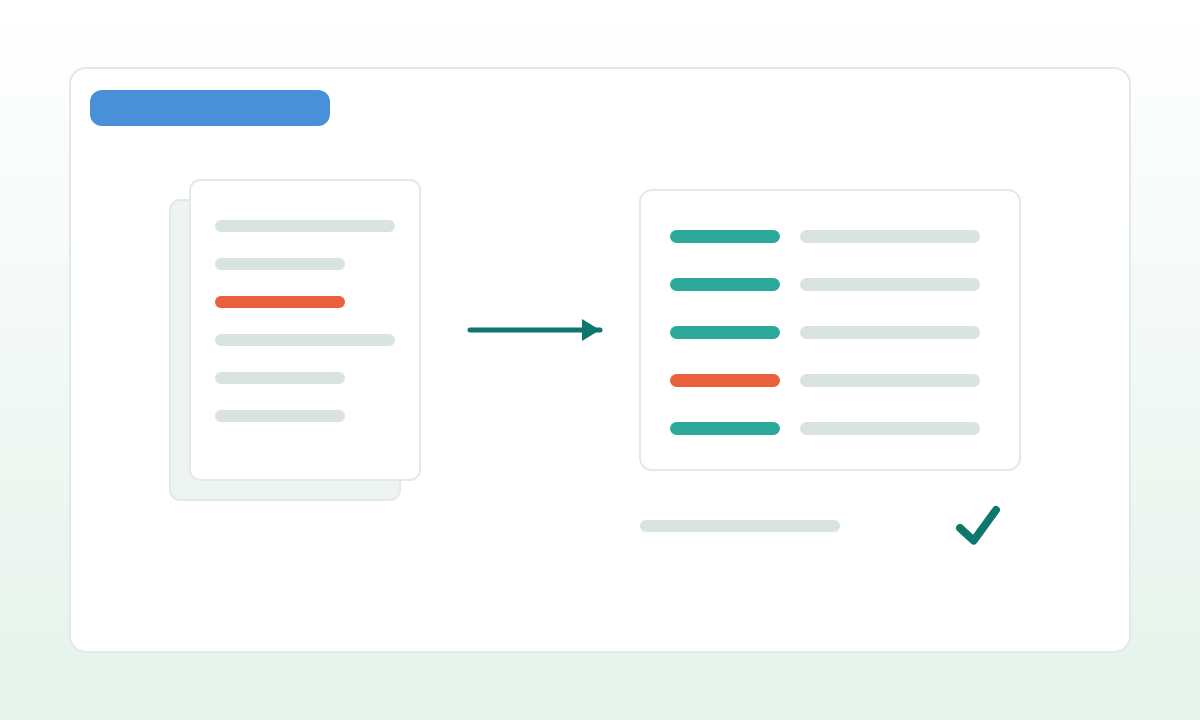
PDF、フォーム、スクリーンショット、添付ファイルは、プロダクトの外側に残りがちです。誰かが読み、値をコピーし、例外を確認し、アプリ、スプレッドシート、CRM、バックエンドへ入力しています。
そのため文書自動化は、最初のソフトウェアスプリントに向いています。入力が見えやすく、出力を確認しやすく、結果をアプリやAPIへ渡せるからです。抽象的な「AI戦略」案件と異なり、文書自動化にはBefore/Afterが明確にあります。置き換える手作業は、すでに人件費として帳簿に乗っているからです。
最初のバージョンで行うこと
最初からすべての文書種別を扱う必要はありません。件数が多い受付経路に絞るべきです。
- PDF、フォーム、メール、アップロードファイルを読み取る
- 名前、日付、ID、金額、メモ、分類ラベルを抽出する
- 各抽出項目の根拠を表示する
- 信頼度が低い値を人の確認へ回す
- 承認済みレコードをCSV、スプレッドシート、API、DB、キューへ渡す
これにより、危険な完全自動化を避けながら実務で役立つ仕組みにできます。
最初のスプリントで動くリファレンス構成:
受信経路: メール添付 / S3アップロード / SFTP / Webフォーム
  → ファイルストレージ(S3、GCS、Azure Blob)に原本保存
  → 形式振り分け:
      デジタルPDF → pdfplumber / pdf.js / Apache Tika
      スキャンPDF・画像 → OCR(Azure Document Intelligence、AWS Textract、
                              Google Document AI、Tesseract+layout-parser)
      Office文書 → unoconv / docx2txt
  → レイアウト情報付きテキスト+トークンごとのバウンディングボックス
  → 厳格なJSON Schema(Pydantic / Zod)でLLM抽出:
      {
        invoice_number, issue_date, due_date,
        supplier_name, supplier_tax_id,
        total_amount, currency,
        line_items: [...],
        confidence_per_field, evidence_bbox_per_field
      }
  → 検証ルール(合計=明細合計、日付の妥当性、IDの正規表現)
  → 信頼度ルーティング: 高 → 自動承認キュー
                        中 → フィールド事前入力済みのレビュー画面
                        低 → AIヒント付きの手入力
  → 承認時に記録システムへ書込(会計API、CRM、社内DB)
                + 下流ワーカー向けにメッセージキューへイベント発行
後で効いてくる2つの設計ルール:
- 各フィールドの「根拠」を保存する。 バウンディングボックス、ページ番号、生のOCRスニペット。これがないと監査・異議対応が不可能になります。あれば、レビュー画面でモデルが読んだ箇所を正確にハイライトできます。
- 抽出は「データ」であって「テキスト」ではない。 モデルはスキーマ検証済みの構造化JSONを返します。検証失敗の出力は訂正プロンプトで再試行し、それでも失敗なら手動レビューへ。下流で自由形式の文章をパースしない。
測るべき指標
削減時間、手戻り削減、レビュー後の抽出精度、追加確認なしで進められるレコード数を測ります。
初日から追う具体的な指標:
- フィールド単位の Precision/Recall。 文書単位ではなく。文書単位90%でも、重要フィールドの再現率が30%という事態は普通に起こる。ラベル付きホールドアウト50〜200件で計算。
- 自動承認率。 すべての信頼度・検証しきい値を通過し、人手編集なしで進んだ割合。請求書系で最初のスプリント時に50〜70%が現実的。それより高い場合は、しきい値が緩いか、対象が狭すぎる可能性。
- 1文書あたり所要時間。 中央値とP95。手作業ベースラインと比較。
- フィールド別レビュアー上書き率。 次にプロンプト/モデルを改善すべきフィールドを特定できる。
- 1文書あたりコスト。 OCR + モデルトークン + レビュアー分単価。規模が出れば手作業の1/5〜1/20が一般的だが、暗黙ではなく明示的に計算すること。
数字に説得力があれば、次の投資はプロダクト連携、権限、監視、顧客向けワークフローへ進められます。
PoCに向いている理由
入力が繰り返しで、出力を確認しやすく、業務責任者が手作業コストを理解していることが多いため、文書自動化は数週間でソフトウェアの証拠を作りやすいテーマです。
さらに、永続的な資産が残ります。スキーマ、抽出プロンプト、検証ルール、レビューUIはPoC後も使い続けられます。文書自動化は自然に拡張します。今月は請求書、来月は発注書、翌四半期は契約書。それぞれが同じパイプラインに新しいスキーマと新しいプロンプトを足すだけで動きます。この複利的な性質こそ、「変革」を売り込まずに小さな最初のスプリントが複数年DXプログラムの起点になり得る理由です。